
 0


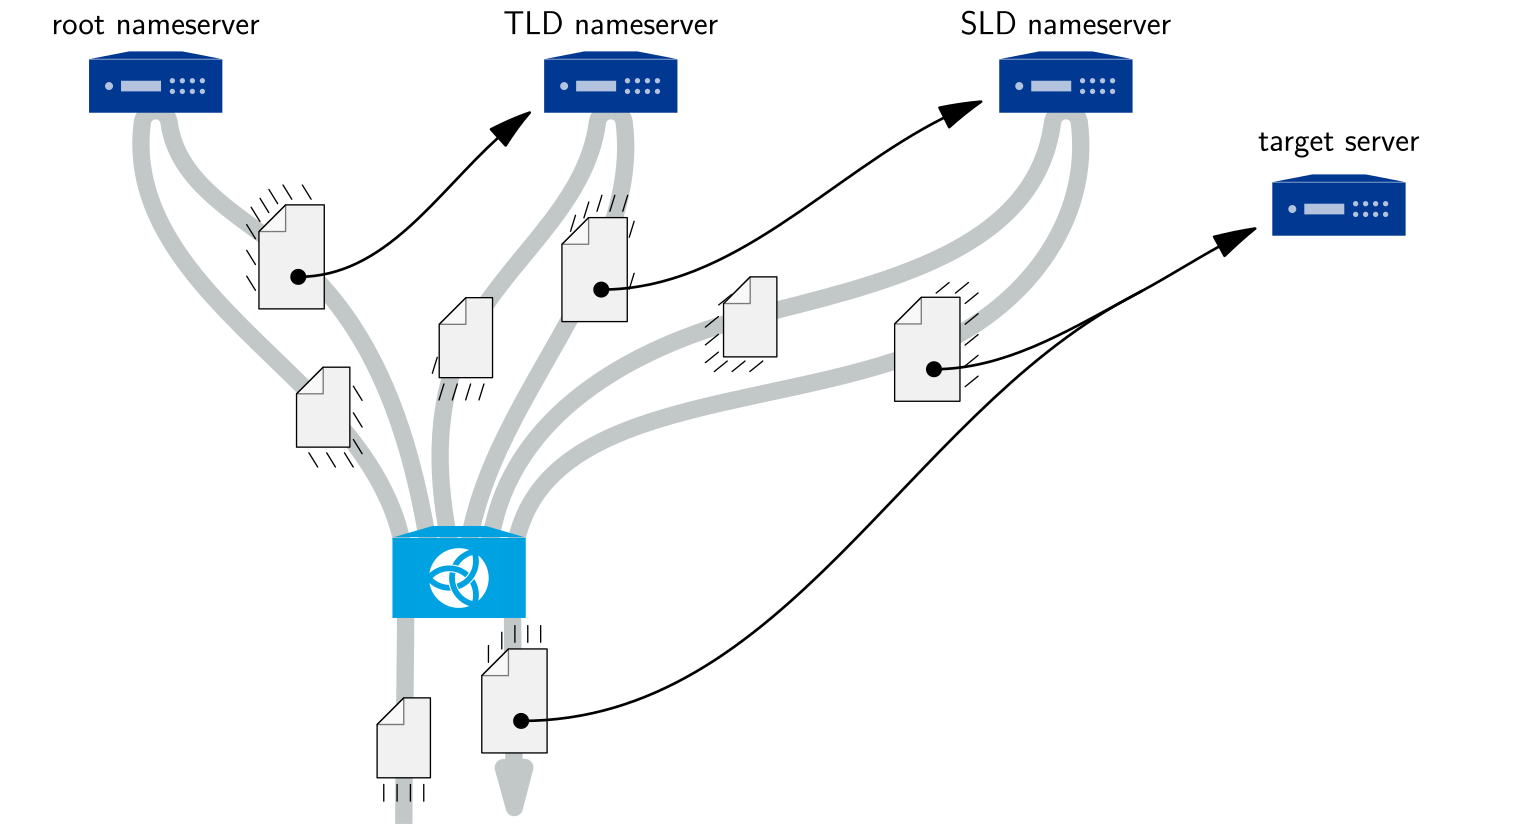
Zjednodušeně je překlad doménového jména znázorněn na následujícím obrázku. Uživatel nám pošle dotaz a my postupně posíláme dotazy autoritativním serverům od kořene, až se dozvíme konečnou odpověď, kterou pošleme uživateli. Ve skutečnosti ale dotazů může být výrazně více kvůli přesměrováním přes záznamy CNAME a DNAME, potřebě podpisů DNSSECu pro validaci záznamů, atp. Mít potřebné záznamy okamžitě přístupné z keše má proto na dobu zpracování výrazný vliv, zvláště když se klienti obvykle ptají na tytéž nejčastější dotazy.
Po obdržení odpovědi od autoritativního serveru ji uložíme do keše. Protože je ale její velikost omezená, může být občas potřeba z ní některé záznamy vyhodit a k tomu slouží garbage collector. V určených intervalech kontroluje zaplněnost keše a při překročení limitu ji celou projde a určité procento paměti uvolní. Hlavní zde tedy je umět rozhodnout, které záznamy bychom měli v keši ponechat.
Ještě lepší by bylo dotazovat se autoritativních serverů s předstihem na záznamy, které budou brzy potřeba. Existují různé přístupy, jak se snažit uhodnout ty správné dotazy, založené na historii uživatelských dotazů, jejich pravidelnosti, atp. My se zde budeme držet konzervativnějšího přístupu, kdy pouze aktualizujeme užitečné záznamy krátce před jejich expirací. Funkce zvaná prefetch je navržena tak, abychom uměli garantovat, že nezvýšíme počet dotazů k autoritativním serverům příliš – konkrétně omezíme zvýšení počtu našich dotazů určitým zlomkem uživatelských dotazů, které příslušné záznamy využívají. Také se snažíme, aby prefetch nenavyšoval využitou paměť, a to tak, že aktualizujeme pouze položky, které jsou aktuálně v keši. I tak ale může dojít k přidání nových záznamů, které byly potřeba k aktualizaci jiných.
Hlavní a společná část obou těchto mechanismů je určování užitečnosti jednotlivých záznamů. Jak garbage collector, tak prefetch již byly součástí předchozích verzí, ale vybírání záznamů k zahození nebo aktualizaci nebylo příliš propracované. Aktuální klasifikace užitečnosti záznamů je založena na naší datové struktuře KRU, o které jsme psali v souvislosti s ochranou proti DoS útokům a později podrobněji popsali její technické řešení. Zde nám tato datová struktura umožňuje počítat přístupy k jednotlivým záznamům v keši, abychom následně mohli porovnávat, jak často byly v nedávné době využívané.
V následujícím textu si nejprve připomeneme základní vlastnosti datové struktury KRU. Poté si podrobněji popíšeme garbage collector a rozdíly mezi jeho starou a novou verzí a zlepšení doložíme grafy s výsledky měření. Podobně si popíšeme nový prefetch, zmíníme jeho předchůdce a opět ukážeme výsledky experimentálního srovnání. Nakonec okomentujeme, jak se vyhnout střídavému aktualizování a zahazování stejných záznamů kvůli špatné konfiguraci.
Garbage collector založený na KRU je již součástí Knot Resolveru od verze 6.0.17, nový prefetch bude součástí příští verze 6.6.0.
Určování užitečnosti pomocí KRU
Datová struktura Knot Recently Used uchovává čítače, které můžeme efektivně číst a navyšovat jejich hodnotu. Ta s časem exponenciálně klesá, takže spíše než o počet určitých událostí jde o jejich frekvenci v nedávné době (viz články odkazované v úvodu).
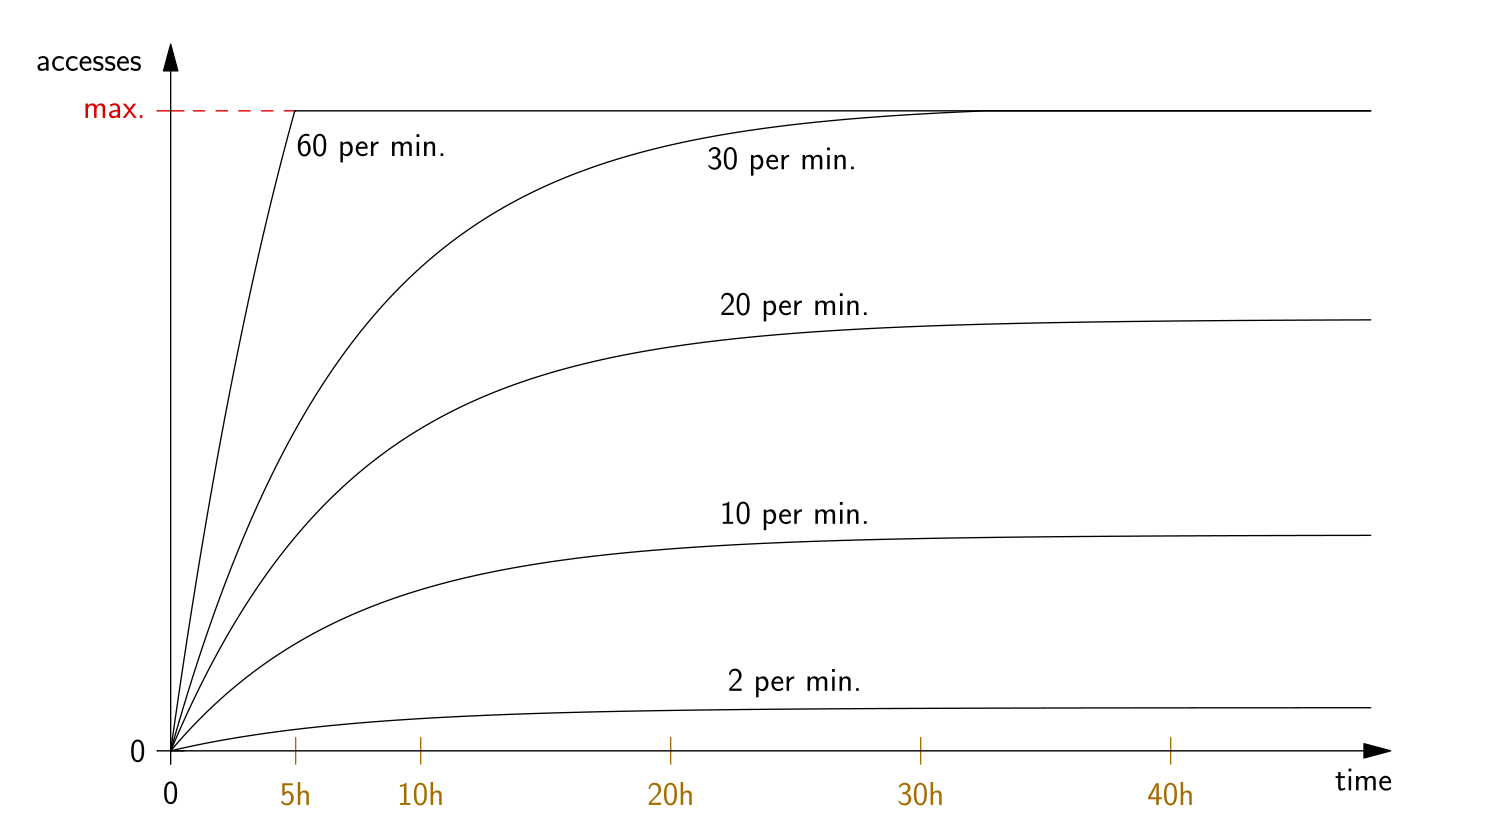
Zde konkrétně počítáme přístupy k jednotlivým záznamům v keši a čítače se každou sekundu násobí konstantou mírně menší než jedna, aby se hodnoty dostaly na polovinu za 5 hodin. S danou přesností čítačů se pak konkrétní přístupy úplně zapomenou po asi 80 hodinách. Za předpokladu pravidelných přístupů se kombinace lineárního navyšování a exponenciálního klesání ustálí na hodnotě úměrné frekvenci přístupů, jak lze vidět na následujícím grafu. Čím vyšší je hodnota čítače, tím užitečnější pro nás příslušný záznam bude.
Velikost KRU je konstantní, musí být zaokrouhlená na mocninu dvojky a tvoří 6–13 % nastavené velikosti keše. Datovou část keše pro ukládání záznamů jsme oproti předchozím verzím příslušně zmenšili.
Záznamy v keši a čítače v KRU jsou na sobě nezávislé, co se týče jejich existence. Může se stát, že záznam vyhodíme z keše, protože expiroval, ale stále mu zůstane vysoká hodnota v KRU. Nebo naopak hodnota čítače klesne na nulu, ale záznam v keši zůstane, protože nebylo potřeba nic vyhazovat. Z návrhu KRU dokonce ani není možné říct, že čítač nějakého záznamu neexistuje – ty s příliš nízkými hodnotami se jen slučují dohromady a naopak nové záznamy můžou s rostoucí popularitou přebírat sdílené hodnoty.
Používané metriky pro garbage collector a prefetch jsou ve skutečnosti mírně odlišné. V prvním případě je omezeným zdrojem velikost keše, takže nás zajímá přístupová frekvence na bajt keše. Přírůstky čítačů proto dělíme velikostí příslušných záznamů – čím větší je záznam, tím více potřebuje přístupů, abychom jej nevyhodili. Jinými slovy: Není rozdíl v tom, jestli máme jeden záznam s určitým počtem přístupů, nebo dva záznamy poloviční velikosti s polovičním počtem přístupů. V grafu výše se maximální frekvence jednoho přístupu za dvě sekundy, kterou již z hodnoty čítače nedokážeme odlišit od vyšších, vztahuje k námi stanovené normální velikosti záznamů. Pro účely prefetche používáme stejnou instanci KRU, ale přečtené hodnoty zpět násobíme velikostmi záznamů, protože ta už v tomto případě není podstatná.
Garbage Collector
Garbage collector funguje jako samostatný proces spuštěný vedle procesů kresd. Ve výchozím nastavení každou sekundu ověřuje zaplněnost keše, a pokud překročí 80 %, obsah keše se zanalyzuje a 10 % využitého prostoru se uvolní. Všechny tři parametry jsou konfigurovatelné spolu s velikostí keše.
Zmíněná analýza sestává ze dvou sekvenčních skenů všech uložených záznamů. V prvním průchodu přiřadíme každému záznamu celočíselnou kategorii (0–99), kde nižší hodnota znamená vyšší užitečnost, a pro každou kategorii spočítáme, kolik místa její záznamy zabírají. Poté postupně nasčítáváme velikosti kategorií od nejméně užitečných, abychom zjistili, kolik jich budeme chtít zahodit pro požadovanou úsporu místa. Ve druhém průchodu pak znova určíme kategorii každého záznamu, protože tyto hodnoty jsme si nikam neukládali, a pokud překračuje určenou mez, tak záznam smažeme.
Do tohoto bodu funguje vše stejně jako v předchozích verzích, až na samotnou kategorizaci, která je kompletně přepsaná.
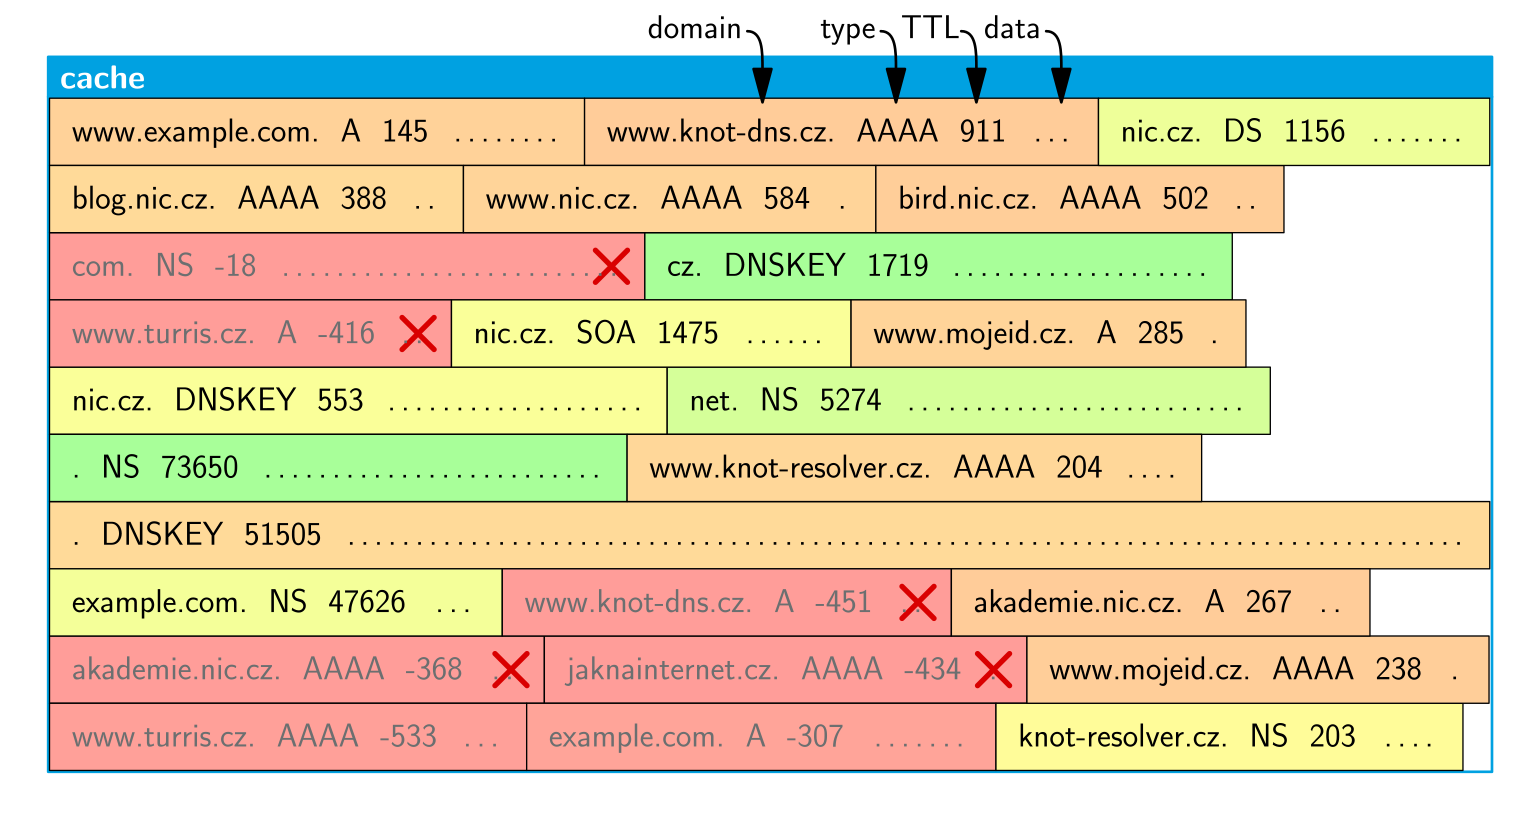
Původně jsme neukládali žádné informace o přístupech k záznamům, a pro rozhodování o užitečnosti jsme tak využívali jen jejich samotná data. Konkrétně jsme záznamy dělili do skupiny expirovaných domén, platných domén 3. a nižších úrovní, platných domén 2. úrovně a platných domén 1. úrovně; uvolňování pak probíhalo v tomto pořadí. Jako méně důležitá kritéria pro rozhodování se používaly typ záznamu a to, jestli je záznam větší než je běžné, a poté se rozhodovalo náhodně. Obvykle se tak nejprve smazaly expirované záznamy a poté od nejnižších úrovní bez ohledu na jejich popularitu. Příklad takové kategorizace (od zelené po červenou) je na následujícím obrázku.
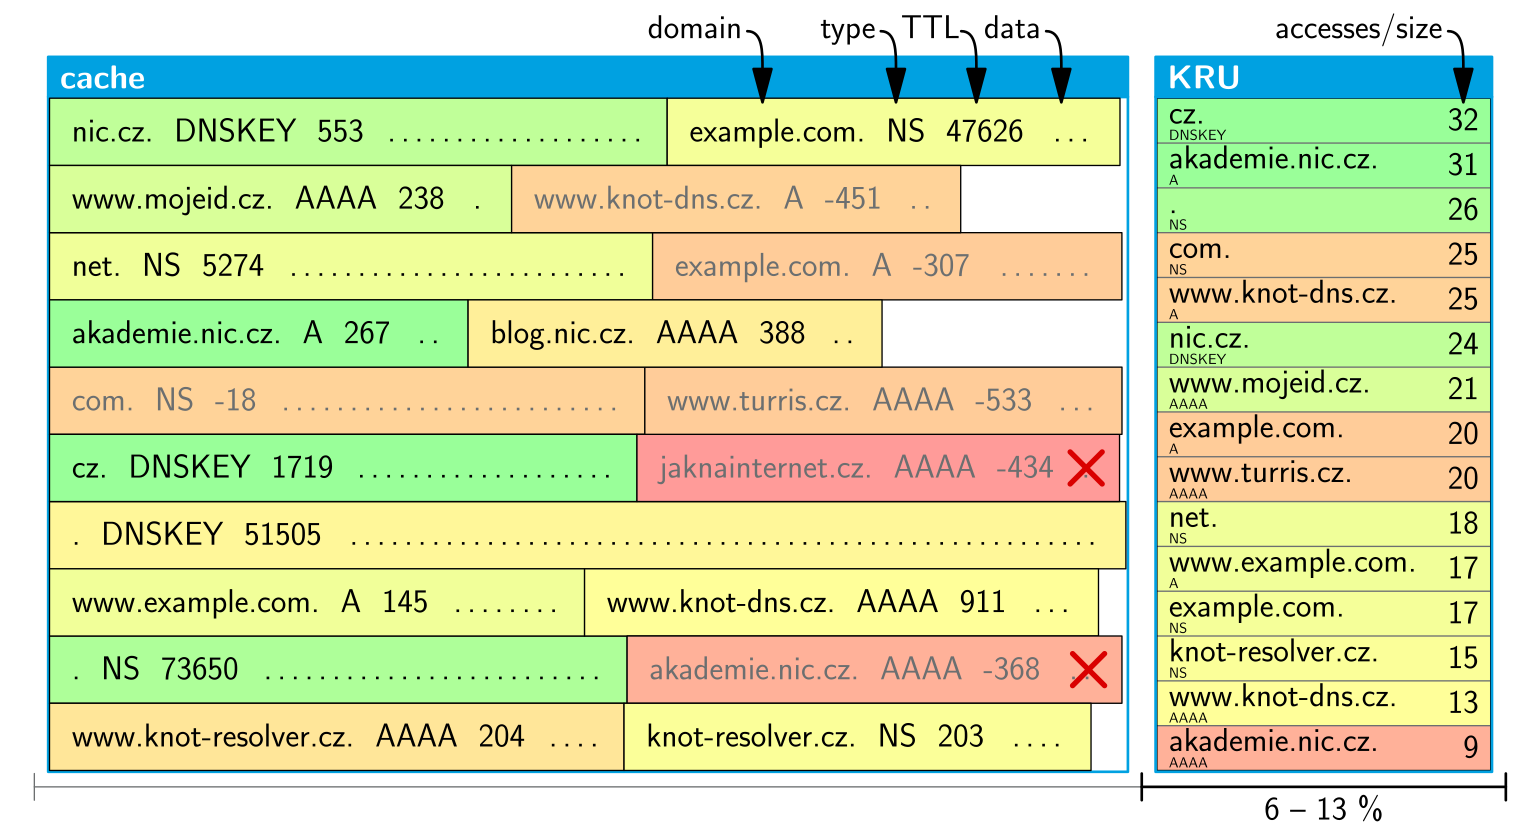
V nové verzi jsme velikost časti keše pro záznamy zmenšili, abychom vedle ní mohli ukládat KRU se statistikami o použití. Kategorizace pak funguje tak, že se nejprve podíváme na to, jestli je záznam expirovaný, čímž rozdělíme kategorie na poloviny, a v obou poté použijeme jako sekundární kritérium přístupovou frekvenci na bajt z KRU. Na následujícím obrázku je vidět, že vzniklé rozdělení je i jemnější než v původní verzi, kde jsme všechny kategorie ani nevyužili.
Výsledky měření
Pro změření zlepšení na reálném provozu potřebujeme co nejdelší záznam, aby hodnoty v KRU byly dostatečně relevantní. Úmyslně zde používáme malou keš pro zvýraznění rozhodnutí garbage collectoru. Na druhou stranu není potřeba příliš vysoká frekvence dotazů. Konkrétně jsme použili záznam 9 hodin provozu s 2 000 dotazy za sekundu a velikost keše 25 MB. Pro srovnání pak používáme 40 GB keš, kde garbage collector není vůbec potřeba, a je to tedy to nejlepší, k čemu bychom se mohli přiblížit.
Pro porovnání implementací měříme latenci odpovídání resolveru na dotazy, která je významně ovlivněna tím, kolik z požadovaných autoritativních odpovědí máme uloženo v keši. Na následujícím logaritmickém histogramu percentilů latencí je vidět, že nové řešení založené na KRU je mnohem blíže křivce s velkou keší než původní implementace.
Pro získání lepší představy, jak tento graf interpretovat, začněme s tím, že máme všechny změřené doby odpovědí na jednotlivé dotazy na svislé ose, seřadíme je od nejvyšších k nejnižším zleva doprava a křivku vedeme těmito body. Nižší latence způsobí posun křivky dolů a zmenšení počtu pomalých odpovědí posune odpovídající část křivky doleva – tyto dva směry tedy představují zlepšení. Obě osy zde mají navíc logaritmickou stupnici, aby se zvýraznil počet pomalých odpovědí, ale současně zůstaly vzájemně porovnatelné odpovědi s latencí o několik řádů nižší.
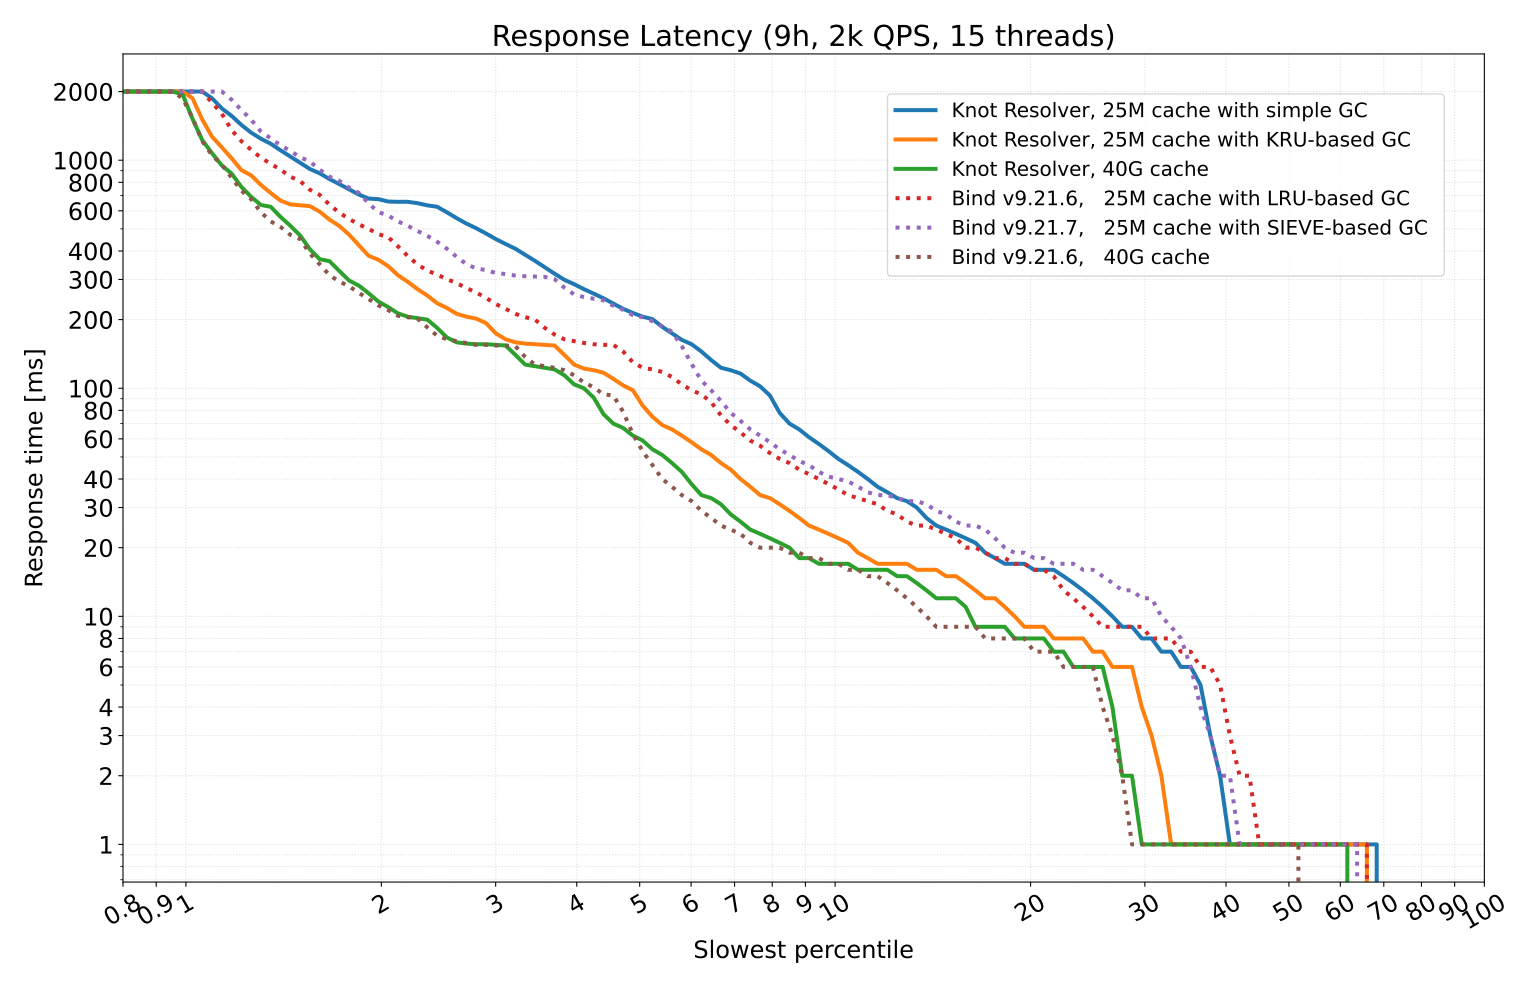
Stejné měření jsme provedli také na BINDu 9. Výsledky jsou v grafu tečkovaně a naše implementace založená na KRU se v těchto podmínkách jeví jako lepší. Trochu nečekané je to, že měření jejich novějšího garbage collectoru založeného na algoritmu SIEVE zde dopadá o něco hůře než původní založený na LRU. Přímo v rozporu s výsledky jejich měření to ale není, protože používali záznam s výrazně vyšší frekvencí dotazů než my. Jejich cílem při návrhu nového garbage collectoru totiž bylo zvýšení propustnosti omezené častým zamykáním v LRU namísto lepšího odhadu užitečnosti záznamů. Naše datová struktura KRU je už z návrhu bezzámková, porovnání propustnosti ale nebylo součástí našich měření.
Prefetch
Původně se pro přednačítání záznamů do keše používaly moduly Lua prefetch a predict. První z nich aktualizoval záznamy, na něž se někdo dotázal krátce před jejich expirací – statisticky tento mechanismus fungoval, ale s KRU můžeme mít rozhodování přesnější. Druhý modul se snažil naučit, kdy se které záznamy používají, což ale byla pouze experimentální funkce nedoporučená k produkčnímu nasazení. Nyní již nedoporučujeme používat ani jeden z nich a ani je nelze aktivovat z konfigurace v YAMLu; přes Lua jejich aktivace zatím možná je.
Nový prefetch je napsaný přímo v C, přejímá konfigurační volby YAMLu svého předchůdce a rozšiřuje je o další volitelná nastavení. Konkrétně lze upravit omezení na nárůst provozu na autoritativní servery ve vztahu k počtu uživatelských dotazů, jak časté přístupy jsou pro aktualizaci vyžadovány a jak dlouho před expirací by se měly záznamy aktualizovat.
Jak jsme zmínili výše, z hodnoty čítače v KRU můžeme zjistit frekvenci přístupů k záznamu za předpokladu, že jsou přístupy pravidelné. To nám ale pro zmíněnou garanci nízkého nárůstu provozu stačit nebude. Chceme, aby na každou aktualizaci byl potřeba určitý minimální počet uživatelských dotazů, které aktualizovaná data využívají, a abychom nezapočítali stejné klientské dotazy opakovaně. Označme tento minimální počet dotazů k.
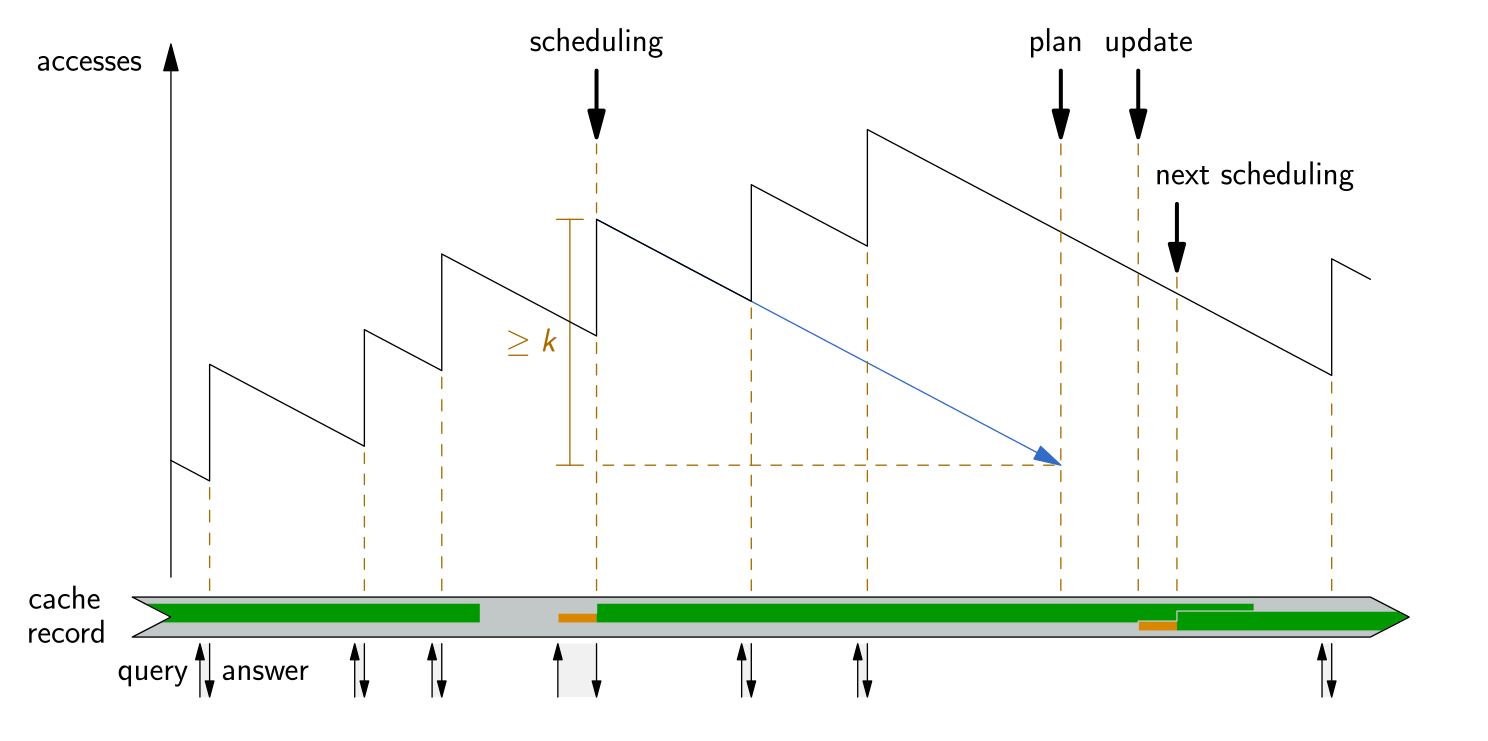
Potřebujeme tedy, aby hodnota čítače byla tak vysoká, že ji exponenciální klesání sníží o k dříve, než budeme rozhodovat o další aktualizaci tohoto záznamu. Tímto zachytíme nejhorší případ, kdy všech k přístupů nastane těsně před čtením hodnoty; pro pravidelné přístupy bude požadavek striktnější. Může se stát, že nové přístupy pokles vyrovnají, ale to nás v tomto případě nezajímá, protože uvažujeme jen předpokládaný pokles za daný čas na základě aktuální hodnoty. Zůstane-li hodnota vlivem nových přístupů stále vysoká, můžeme při příští aktualizaci provést stejnou úvahu s novými k přístupy.
Nyní by se nabízelo přečíst hodnotu těsně před možnou aktualizací a spočítat předpokládaný pokles za dobu její nové platnosti. Novou platnost se ale dozvíme až po aktualizaci. Namísto toho se podíváme na hodnotu čítače těsně po získání záznamu z autoritativního serveru, a je-li dostatečně vysoká, naplánujeme aktualizaci krátce před expiraci záznamu. Konkrétně uvažujeme pokles za dobu mezi získáním záznamu a okamžikem, na kdy bychom chtěli aktualizaci naplánovat, což je minimálně 5 sekund před expirací. Aktualizace pak proběhne co nejdříve po tomto okamžiku, jakmile nebudou procesy kresd příliš vytížené.
Průběh plánování aktualizace je znázorněn na následujícím obrázku. Vodorovná osa představuje čas, uvnitř ní jsou zelenými obdélníky naznačeny doby platnosti potenciálně různých verzí stejného záznamu a oranžové intervaly představují probíhající aktualizaci záznamu. Příslušné uživatelské dotazy a jejich odpovědi jsou pod časovou osou a vývoj hodnoty čítače záznamu v KRU zubatou čarou nad osou. Přijetí záznamu na uživatelský dotaz zde iniciovalo plánování aktualizace a příslušný plán označuje, kdy by k ní mělo dojít. Skutečná aktualizace pak nastane o něco později a po obdržení aktualizovaného záznamu začíná nové plánování.
Podobně přidáme požadavek na minimální frekvenci přístupů, nebo přesněji maximální periodu přístupů. Pokles čítače tedy musí být aspoň o jeden dotaz za daný časový interval. Poznamenejme, že z principu fungování exponenciálního snižování čítačů je rozdíl mezi poklesem o jeden přístup za určitý čas a o dva přístupy za dvojnásobný čas, proto zde považujeme vyjádření pomocí periody za přesnější.
Oba požadavky nám dají spodní mez na hodnotu čítače, přičemž podle doby expirace konkrétního záznamu může být někdy striktnější jeden a jindy druhý, takže použijeme vyšší z nich. Splnění této meze vyžadujeme jak v čase plánování, tak i těsně před aktualizací. Pro účely garance nízkého provozu nás sice splnění zajímá jen v čase plánování; intuitivně se ale zdá být podstatnější popularita těsně před aktualizací. U požadavku na maximální periodu by zase dávalo smysl vyžadovat jeho splnění po celou dobu existence záznamu, což by ale z technických důvodů bylo komplikovanější, takže provádíme test jen dvakrát.
Aktualizace je naplánována minimálně 5 sekund před expirací. Konkrétně lze nastavit, aby tato doba byla nějaké procento původní doby platnosti, výchozí je 1 %, ale stále minimálně zmíněných 5 sekund. Zvýšením této hodnoty se můžeme u frekventovaných dotazů vyvarovat vracení záznamů s nízkým zbývajícím TTL z keše, což může snížit počet opakovaných dotazů od klientů s vlastní keší, a tedy snížit provoz od nich k nám. Na druhou stranu tím také zkrátíme sledovaný čas mezi získáním záznamu a následnou aktualizací, čímž se zpřísní požadavek na nízké navýšení provozu a navýší počet našich opakovaných dotazů na stále aktualizované záznamy.
V případě, že se nestihne zahájit aktualizace ani 2 sekundy před expirací záznamu, začne spočítaná mez na hodnotu čítače růst až do času expirace, kdy je aktualizace záznamu zrušena. Tímto způsobem se snažíme při vytížení serveru vybírat jen ty nejužitečnější dotazy pro aktualizaci z již vybraných. Zároveň nechceme odkládat aktualizaci až za dobu expirace, abychom tím příliš nekaskádovali zpoždění pro ostatní záznamy.
Upozorněme že v režimu forwardingu používání prefetche nejspíš nebude fungovat správně, protože aktualizace před expirací způsobí jen opětovné získání záznamu uloženého v keši o úroveň výše bez navýšení jeho doby platnosti.
Výsledky měření
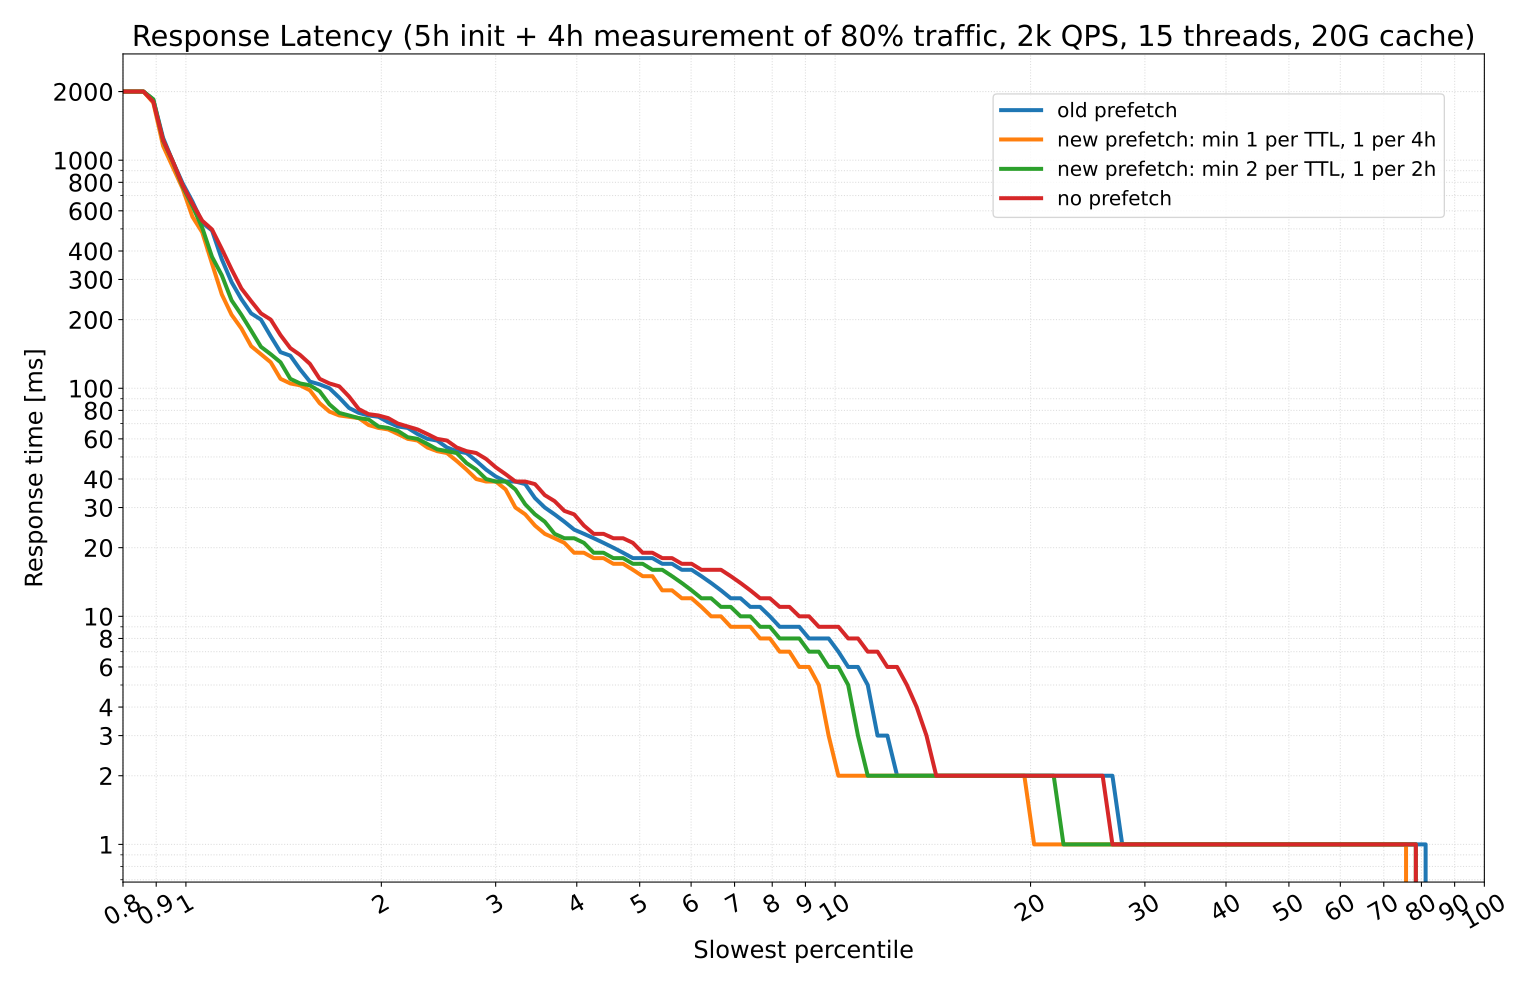
Při měřeních jsme tentokrát použili velkou keš, aby v ní záznamy zůstávaly až do expirace, a mohly se tak projevit jejich aktualizace. Opět jsme využili 9h záznam, ale jeho přehrávání jsme rozdělili do dvou fází: Latence z prvních 5 hodin jsme do měření nezapočítávali a využili jsme je jen k nasbírání statistik o přístupech v KRU, zbylé 4 hodiny pak probíhalo měření jako v předchozím případě. Důvodem je to, že zde porovnáváme hodnoty čítačů s absolutními mezemi a nejen navzájem. Pro autentické měření chování během dlouhodobého provozu bychom potřebovali dostat čítače do stavu po několikadenním provozu. Jelikož 5 hodin je poločas jejich exponenciálního klesání, můžeme předpokládat, že po této době budou hodnoty čítačů přibližně poloviční než při dlouhodobém provozu. U měření nás proto vedle výchozího nastavení bude zajímat také nastavení s polovičními limity na přístupové frekvence, s nímž by pak výsledek mohl být blíže dlouhodobému provozu s výchozím nastavením.
Další změnou je to, že jsme v grafu sledovali pouze 80 % provozu s nejvíce opakovanými dotazy pro zvýraznění vlivu prefetche. Dotazy, které se příliš neopakují, nejspíš žádné aktualizace nezpůsobí, a nebude zde tak rozdíl v latencích při různých měřeních. Při použití našeho záznamu se sledované dotazy opakují minimálně s průměrnou frekvencí jednoho dotazu za 30 minut a obsahují 1/8 všech unikátních dotazů.
V následujícím grafu je srovnání čtyř variant: bez použití prefetche, starý prefetch modul (ale ne predict) a nový prefetch se dvěma nastaveními. Výchozí nastavení představuje zelená křivka, ale u dlouhodobého běhu bychom očekávali chování blíže ke žluté křivce z důvodů uvedených výše. Obě křivky nového prefetche dopadly lépe než zbylé dvě.
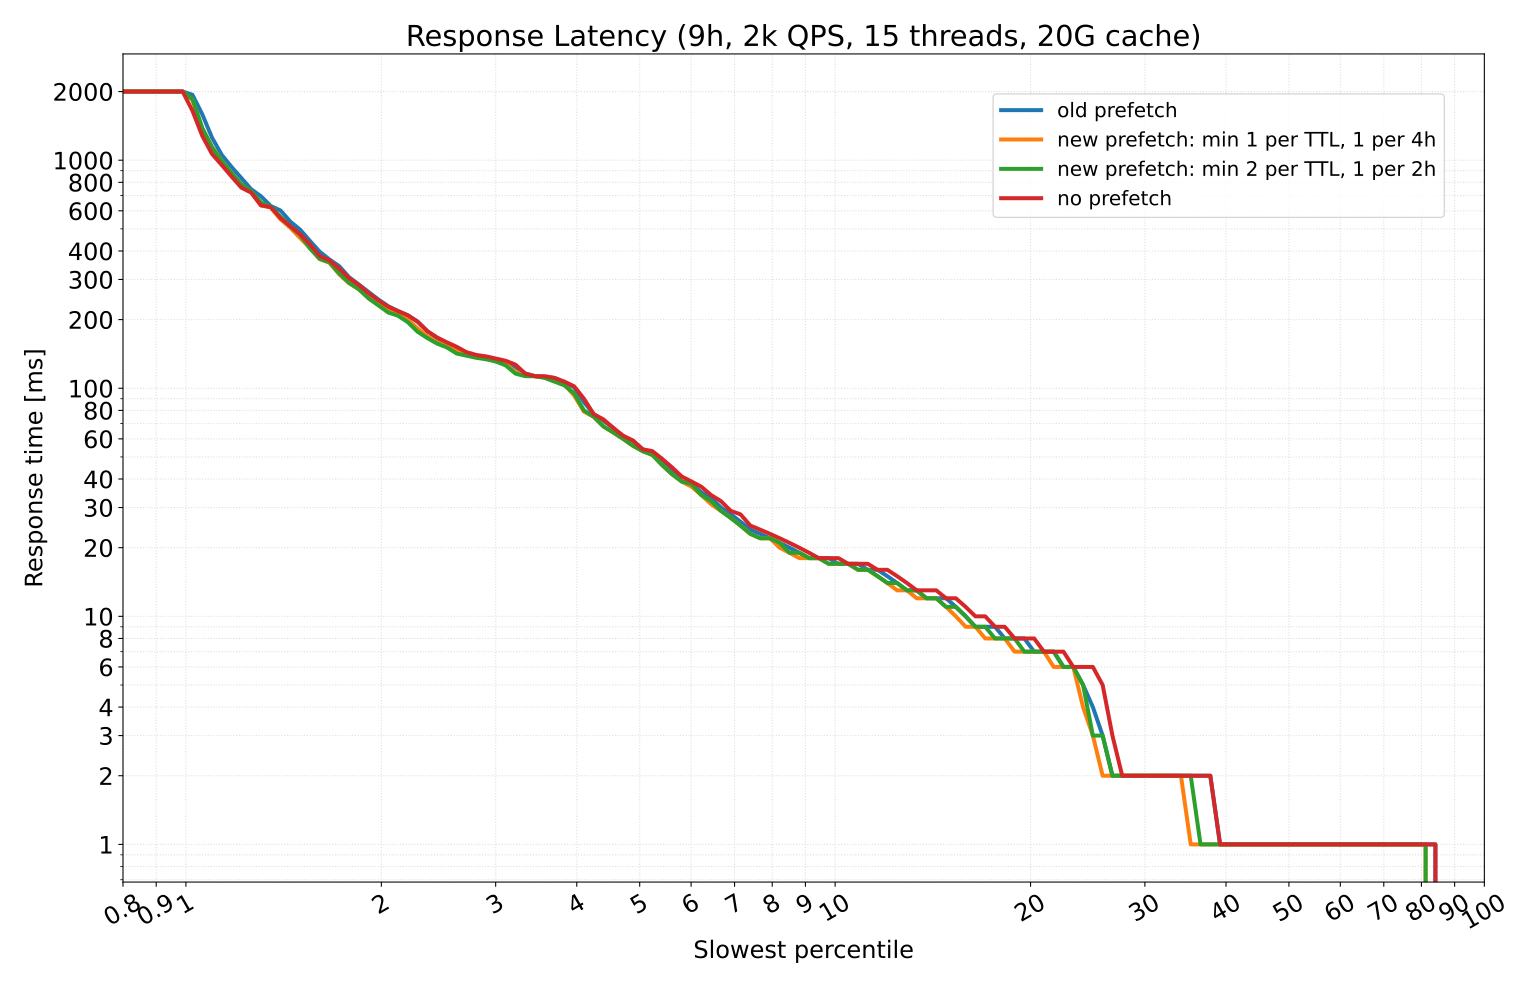
Pro úplnost přidáváme také graf se započítáním všech dotazů, tedy celých 9 hodin běhu a včetně méně opakovaných dotazů. Zlepšení je zde stále patrné, ale dle očekávání není nijak výrazné.
Konfigurace keše a statistiky garbage collectoru
Nalezení správné velikosti keše nemusí být snadné. Nyní máme navíc nové konfigurační volby týkající se prefetche a vzhledem k tomu, že má v určitém smyslu opačné cíle než garbage collector, může při špatné konfiguraci docházet k jejich střetům. Jako vodítko k úpravám konfigurace jsme proto přidali podrobnější statistiky o tom, co garbage collector vyhazuje z keše, ze kterých by měly být patrné některé možné problémy.
Základní rada pro velikost keše je následující: Pro osobní použití a malé kanceláře by měly stačit desítky MB. Není-li potřeba šetřit, použijte 100 MB. Velká vyhrazená nasazení můžou pro keš využít i několik GB. Stále ale mějte na paměti, že se celá keš musí vejít do paměti RAM, i když je její soubor uložen na disku, aby se předešlo zbytečným výpadkům stránek a následným ztrátám výkonu. Také je potřeba nechat dostatek paměti systému – na lokální data a aspoň 50–100 MB na každý proces kresd podle očekávaného zatížení (toto platí převážně pro UDP provoz a verzi 6.5.0, která má výrazně nižší paměťové nároky než předchozí verze). Při vysokém zatížení může spotřeba paměti procesy kresd růst, doporučujeme jim proto nechat více a začít s menší keší. Pokud se uvolňování paměti garbage collectorem spouští jen občas, zvolená velikost keše je zřejmě dostatečná, v opačném případě zkontrolujte výstup garbage collectoru.
V logu najdete následující řádky po každé analýze keše, tj. po zjištění překročení nastavené hranice pro maximální zaplnění keše. Proces garbage collectoru je možné spustit také ručně v režimu dry run, aby jen vypsal statistiky bez uvolňování místa, a s nižší hranicí, aby analýza opravdu proběhla.
Canceling prefetch for
      #.## MB of kept valid RRs eligible for prefetch (limit category #),
      #.## MB of expired RRs (not updated in time, incl. those for removal);
removing (limit category #)
      #.## MB /     #.## MB of valid RRs eligible for prefetch,
      #.## MB /     #.## MB of other valid RRs,
      #.## MB /     #.## MB of expired RRs,
      #.## MB /     #.## MB of RTT entries,
      #.## MB /     #.## MB of prefetch entries (incl. cancellation),
      #.## MB /     #.## MB (# records) in total.
Vedle DNS záznamů RRs (Resource Records) keš obsahuje také položky RTT (Round-Trip Time), které umožňují porovnávat latenci alternativních autoritativních serverů, a nově položky prefetche, které slouží jako časově seřazené ukazatele na záznamy s naplánovanou aktualizací.
Ideálně bychom chtěli vyhazovat pouze expirované záznamy, které již stejně nebudou potřeba, aspoň není-li povoleno stale serving. Odstraňování platných záznamů nemusí být optimální, pokud by byly v budoucnu ještě potřeba, ale vždy nejprve odstraňujeme ty nejméně používané, takže odstranění nějaké jejich malé části může být v pořádku. Je-li jich více, zvažte zvětšení keše.
Ještě větší problém ale je zahazování platných záznamů, které jsou eligible for prefetch, tedy splnily potřebné podmínky při vložení do keše a jejich přístupová frekvence je stále nad spočítanou mezí. V tomto případě je potřeba buď zvětšit keš, nebo nastavit striktnější podmínky prefetche, aby neaktualizoval tak velké množství záznamů. Aktualizují se vždy pouze ty záznamy, které jsou aktuálně v keši, takže jejich odebrání naplánovanou aktualizaci zruší, pří jejich příštím stažení ale může dojít k opětovnému naplánování.
Obezřetnost je potřeba i v případě, kdy garbage collector ruší naplánované aktualizace platných záznamů, které se zatím nezahazují. Ve výchozím nastavení se uvolňuje 10 % obsazeného prostoru keše a pro dalších 10 % se ruší naplánované aktualizace. Tím se vytváří určitý odstup mezi záznamy pro aktualizaci a záznamy pro zahození pro zmírnění střetů. I v tomto případě ale doporučujeme upravit nastavení.
Dalším varováním může být rušení aktualizace expirovaných záznamů. Pokud k němu dochází, procesy kresd neměly dostatek procesorového času, aby jejich aktualizaci zahájily během nastavené doby před expirací. V takovém případě by ale procesy kresd měly samy tyto aktualizace zrušit hned na začátku plánování/aktualizování čehokoliv po zpracování všech čekajících příchozích paketů, k čemuž ale také nedošlo. Jste-li aktuálně pod DoS útokem, jde o korektní chování: dotazy klientů budou prioritizovány podle toho, co se zdá být legitimním provozem, některé dotazy útočníků můžou být zahozeny a prefetch se vůbec nespustí. Pokud k tomuto dochází při běžném provozu, je potřeba zpřísnit podmínky prefetche, případně prozkoumat, jestli je výkon dostatečný. Dalšími z možných příčin mohou být nedávné zakázání prefetche, čímž by se začaly již existující naplánované aktualizace zcela ignorovat procesy kresd, případně delší čas, kdy byl resolver vypnutý.